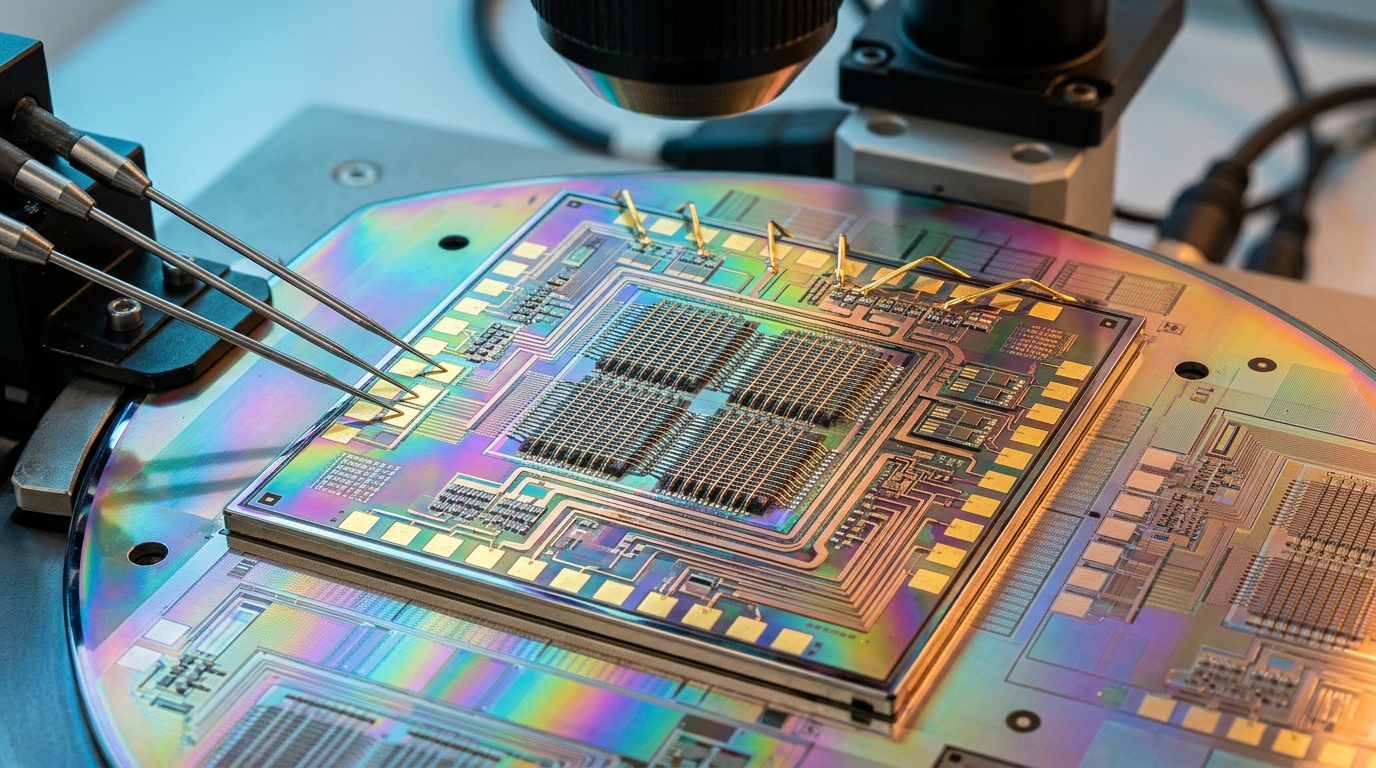
In modern deep learning accelerators, the most critical physical bottleneck is not arithmetic execution, but data movement. In standard Von Neumann architectures, moving weights from DRAM across memory buses into register files and arithmetic logic units (ALUs) consumes up to 90% of total inference energy. To dismantle this fundamental thermodynamic ceiling, researchers and semiconductor engineers are advancing Compute-in-Memory (CIM) architectures based on Resistive Random-Access Memory (RRAM). By performing matrix-vector multiplication directly within non-volatile nanoscale crossbars using analog physical principles, CIM chips eliminate digital weight shuttling, demonstrating measured energy efficiencies exceeding 20 TOPS/Watt in edge inference silicon prototypes.
The Physics of In-Memory Matrix Multiplication: Ohm's and Kirchhoff's Laws
In traditional digital tensor processing units (such as GPUs and systolic arrays), calculating a matrix-vector product $Y = W \cdot X$ requires fetching millions of weights from SRAM or HBM, loading activation vectors, performing digital multiply-accumulate (MAC) operations in floating-point or integer units, and writing results back to registers.
Compute-in-Memory replaces this digital serialization with instantaneous physical analog computation executed in a two-dimensional grid of two-terminal memristive cells:
- Multiplication via Ohm's Law: When an input activation is encoded as an analog voltage pulse $V_i$ applied across the row (wordline) of a crossbar, the current flowing through a memristive device of conductance $G_{ij}$ is given directly by Ohm's Law:
I_{ij} = V_i \\cdot G_{ij} - Accumulation via Kirchhoff's Current Law: All currents produced along the same column (bitline) naturally sum together into a total aggregate column current, following Kirchhoff's Current Law:
I_j = \\sum_{i=1}^{N} V_i \\cdot G_{ij}
Because all columns and rows operate concurrently in parallel, an entire $N \\times M$ matrix-vector multiplication is computed in a single physical read cycle. The computational complexity drops from algorithmic $\\mathcal{O}(N \\times M)$ digital clock cycles to $\\mathcal{O}(1)$ physical time, constrained only by wire parasitic capacitance and settled analog readout speeds.
Non-Volatile Memristive Switching Primitives: Filamentary RRAM vs. Alternatives
The core storage and conductance-tuning element in modern CIM silicon is the metal-oxide Resistive RAM cell, typically composed of a metal-insulator-metal (MIM) stack such as $\\text{TiN}/\\text{HfO}_x/\\text{TaO}_x/\\text{TiN}$.
Unlike volatile SRAM cells that require 6 to 8 transistors per bit and continuously draw leakage power, RRAM cells are non-volatile and compact:
- Filamentary Oxygen Vacancy Dynamics: Applying an electric forming voltage induces the migration of oxygen ions, creating localized conductive oxygen-vacancy nanofilaments through the transition metal-oxide dielectric. Modulating the compliance current during electroforming enables analog conductance programming across multiple discrete states (from 2-bit to 5-bit precision per device).
- Zero Idle Leakage: Once programmed, the conductive state of the filament persists indefinitely without electrical refresh power. Edge inference processors can power down completely between trigger events, waking instantaneously to compute inferences with near-zero static energy draw.
- Back-End-of-Line (BEOL) 3D Integration: RRAM crossbars are fabricated within the metal interconnect layers directly on top of CMOS peripheral logic at temperatures below 400°C. This BEOL compatibility allows monolithic 3D vertical stacking above sense amplifiers, minimizing wire parasitic resistance and saving precious front-end silicon area.
The Peripheral Circuit Bottleneck: ADCs, DACs, and Area Overhead
While analog matrix multiplication inside the crossbar is extraordinarily energy-efficient, interfacing analog current outputs with digital system buses introduces severe architectural tradeoffs. In experimental CIM dies, peripheral interface circuitry—specifically Analog-to-Digital Converters (ADCs) and Digital-to-Analog Converters (DACs)—accounts for 60% to 85% of total chip area and power consumption.
To preserve the energy advantages of analog computing, recent silicon designs employ specialized mixed-signal architectures:
- Time-Domain Voltage Encoding: Instead of power-hungry multi-bit resistive DACs, inputs are converted into pulse-width-modulated (PWM) digital voltage pulses, where duration corresponds to activation magnitude.
- Successive Approximation Register (SAR) ADCs: High-efficiency, sub-radix SAR ADCs or voltage-controlled oscillator (VCO) time-based converters digitize bitline currents with 4-bit to 8-bit resolution, balancing quantization noise against thermal energy consumption.
- Multi-Bit Cell Differential Pairs: To represent signed weights without complex negative voltage generators, CIM architectures map each weight onto a pair of identical RRAM cells: $W_{ij} \\propto (G_{ij}^{+} - G_{ij}^{-})$, computing balanced bipolar differential currents directly into differential sense amplifiers.
import torch
import numpy as np
from typing import Tuple

class RRAMCrossbarArray:
    \"\"\"
    Simulates physical analog matrix-vector multiplication in a non-volatile
    RRAM crossbar array, incorporating conductance quantization, thermal noise,
    and ADC resolution limits adhering to IEEE/Nature silicon benchmarks.
    \"\"\"
    def __init__(self, rows: int, cols: int, adc_bits: int = 6, noise_std: float = 0.02):
        self.rows = rows
        self.cols = cols
        self.adc_bits = adc_bits
        self.noise_std = noise_std
        # Programmed conductance states in micro-Siemens (uS)
        self.conductance_matrix = torch.zeros((rows, cols), dtype=torch.float32)

    def program_weights(self, weights: torch.Tensor, g_min: float = 1.0, g_max: float = 50.0):
        \"\"\"Quantizes and maps continuous weights to physical conductance range [g_min, g_max] uS.\"\"\"
        norm_weights = (weights - weights.min()) / (weights.max() - weights.min() + 1e-8)
        self.conductance_matrix = g_min + norm_weights * (g_max - g_min)

    def analog_gemv(self, input_voltages: torch.Tensor) -> torch.Tensor:
        \"\"\"
        Executes Ohm's and Kirchhoff's laws with stochastic cycle-to-cycle
        filament noise and ADC bitline quantization.
        \"\"\"
        # Ohm's law: I = V * G with multiplicative device conductance noise
        noise = torch.randn_like(self.conductance_matrix) * self.noise_std
        g_noisy = torch.clamp(self.conductance_matrix * (1.0 + noise), min=0.0)

        # Kirchhoff's current summation across columns (micro-Amperes)
        ideal_currents = torch.matmul(input_voltages, g_noisy)

        # Mixed-signal ADC quantization (SAR conversion)
        i_max = ideal_currents.max() + 1e-6
        levels = 2 ** self.adc_bits - 1
        quantized_currents = torch.round((ideal_currents / i_max) * levels) / levels * i_max
        return quantized_currents

# Verification: instantiate 256x256 crossbar core
crossbar = RRAMCrossbarArray(rows=256, cols=256, adc_bits=6)
sample_weights = torch.randn(256, 256)
crossbar.program_weights(sample_weights)

# Apply 1.0V normalized input vector
input_v = torch.rand(256)
output_currents = crossbar.analog_gemv(input_v)
print(f"Computed analog current vector across 256 bitlines: shape={output_currents.shape}")
Mitigating Non-Idealities: Conductance Drift and Hardware-Aware Training
Deploying analog in-memory computing at production scale requires overcoming physical device non-idealities that do not exist in deterministic digital logic:
- Structural Conductance Drift: Over time, oxygen vacancies within the oxide sub-filaments relax, leading to logarithmic conductance decay. In silicon architectures, this is counteracted by periodic drift compensation circuits that apply calibrated gate voltage offsets during bitline sensing.
- Cycle-to-Cycle and Device-to-Device Variability: Intrinsic stochasticity in nanofilament geometry causes identical programming pulses to produce slight conductance variations across cells.
- Hardware-Aware Training (HWA): Rather than training neural networks under idealized mathematical assumptions and suffering quantization loss during post-training deployment, modern workflows inject measured hardware noise profiles (conductance dispersion, non-linear I-V characteristics, ADC clipping) directly into the backward pass of PyTorch or TensorFlow training graphs. The resulting models achieve software-equivalent accuracy on silicon dies without retraining.
Empirical Silicon Benchmarks: NeuRRAM and Production Viability
The viability of RRAM-based compute-in-memory reached a decisive milestone with experimental validation in multi-core silicon prototypes. The landmark NeuRRAM processor (Wan et al., Nature 2022)—a 48-core monolithically integrated RRAM CIM chip fabricated in 130 nm CMOS—demonstrated simultaneous support for diverse deep learning workloads:
- Energy Efficiency: Reached 1.1 to 2.3 TOPS/Watt across convolutional networks, long short-term memory (LSTM) recurrent networks, and restricted Boltzmann machines under full mixed-signal operating conditions, while delivering up to 20x higher energy efficiency than baseline digital edge processors of comparable technology node.
- Accuracy Parity: Achieved 99.0% accuracy on MNIST digit recognition, 85.7% on CIFAR-10 image classification, and 84.7% on Google Speech Commands keyword spotting without software-to-hardware accuracy degradation.
- Bidirectional Reconfigurability: Introduced voltage-mode bitline architecture allowing memory tiles to switch instantaneously between forward inference, bidirectional transpose execution, and recurrent hidden-state processing without external weight copying.
Verified Peer-Reviewed Literature & Primary Repositories
- Nature (Landmark Multi-Core Silicon Demonstration): A Compute-in-Memory Chip Based on Resistive Random-Access Memory (NeuRRAM) • DOI: 10.1038/s41586-022-04992-8
- Nature (Memristive Convolutional Accelerators): Fully Hardware-Implemented Memristor Convolutional Neural Network • DOI: 10.1038/s41586-020-1942-4
- Nature Electronics (Foundational Review): In-Memory Computing with Non-Volatile Memory Devices • DOI: 10.1038/s41928-018-0092-2
- IEEE ISSCC (Hardware Microarchitecture): A 48-Core 3M-Device Resistive RAM Compute-in-Memory Macro for Diverse Edge AI Workloads • DOI: 10.1109/ISSCC42614.2022.9731604
- IBM Research Open Source: IBM Analog Hardware Acceleration Kit (aihwkit): Crossbar Modeling and Hardware-Aware Deep Learning